摘要
隨著互聯網的迅猛發展,新聞網站每天產生海量的新聞數據。傳統的數據處理技術難以應對如此大規模數據的存儲與分析需求。本文設計并實現了一個基于爬蟲、Hadoop、Spark和Hive的新聞數據分析系統,旨在從新聞網站采集數據,通過分布式技術進行存儲、處理和分析,最終以可視化的方式展示新聞熱點、趨勢和情感傾向。該系統充分利用了大數據生態圈組件的優勢,提高了數據處理的效率和可擴展性,為新聞數據分析提供了一種有效的解決方案。
1. 引言
在信息爆炸的時代,新聞數據呈指數級增長。如何從海量新聞中提取有價值的信息,成為學術界和工業界關注的熱點。傳統的關系型數據庫和單機處理方式難以滿足海量數據的存儲與計算需求。大數據技術為此提供了新的思路。本項目結合爬蟲技術、Hadoop分布式文件系統、Spark內存計算框架和Hive數據倉庫,構建了一個完整的新聞數據分析 pipeline,實現了從數據采集到分析可視化的全流程。
2. 系統總體設計
本系統主要由四個模塊組成:數據采集模塊、數據存儲模塊、數據分析模塊和數據可視化模塊。總體架構如下:
- 數據采集:使用Python爬蟲框架Scrapy抓取多個新聞網站的新聞標題、內容、發布時間、來源等字段。
- 數據存儲:原始數據存入Hadoop HDFS,結構化和清洗后的數據存入Hive表。
- 數據分析:利用Spark進行數據清洗、轉換和統計分析,包括詞頻統計、熱點話題挖掘、情感分析等。
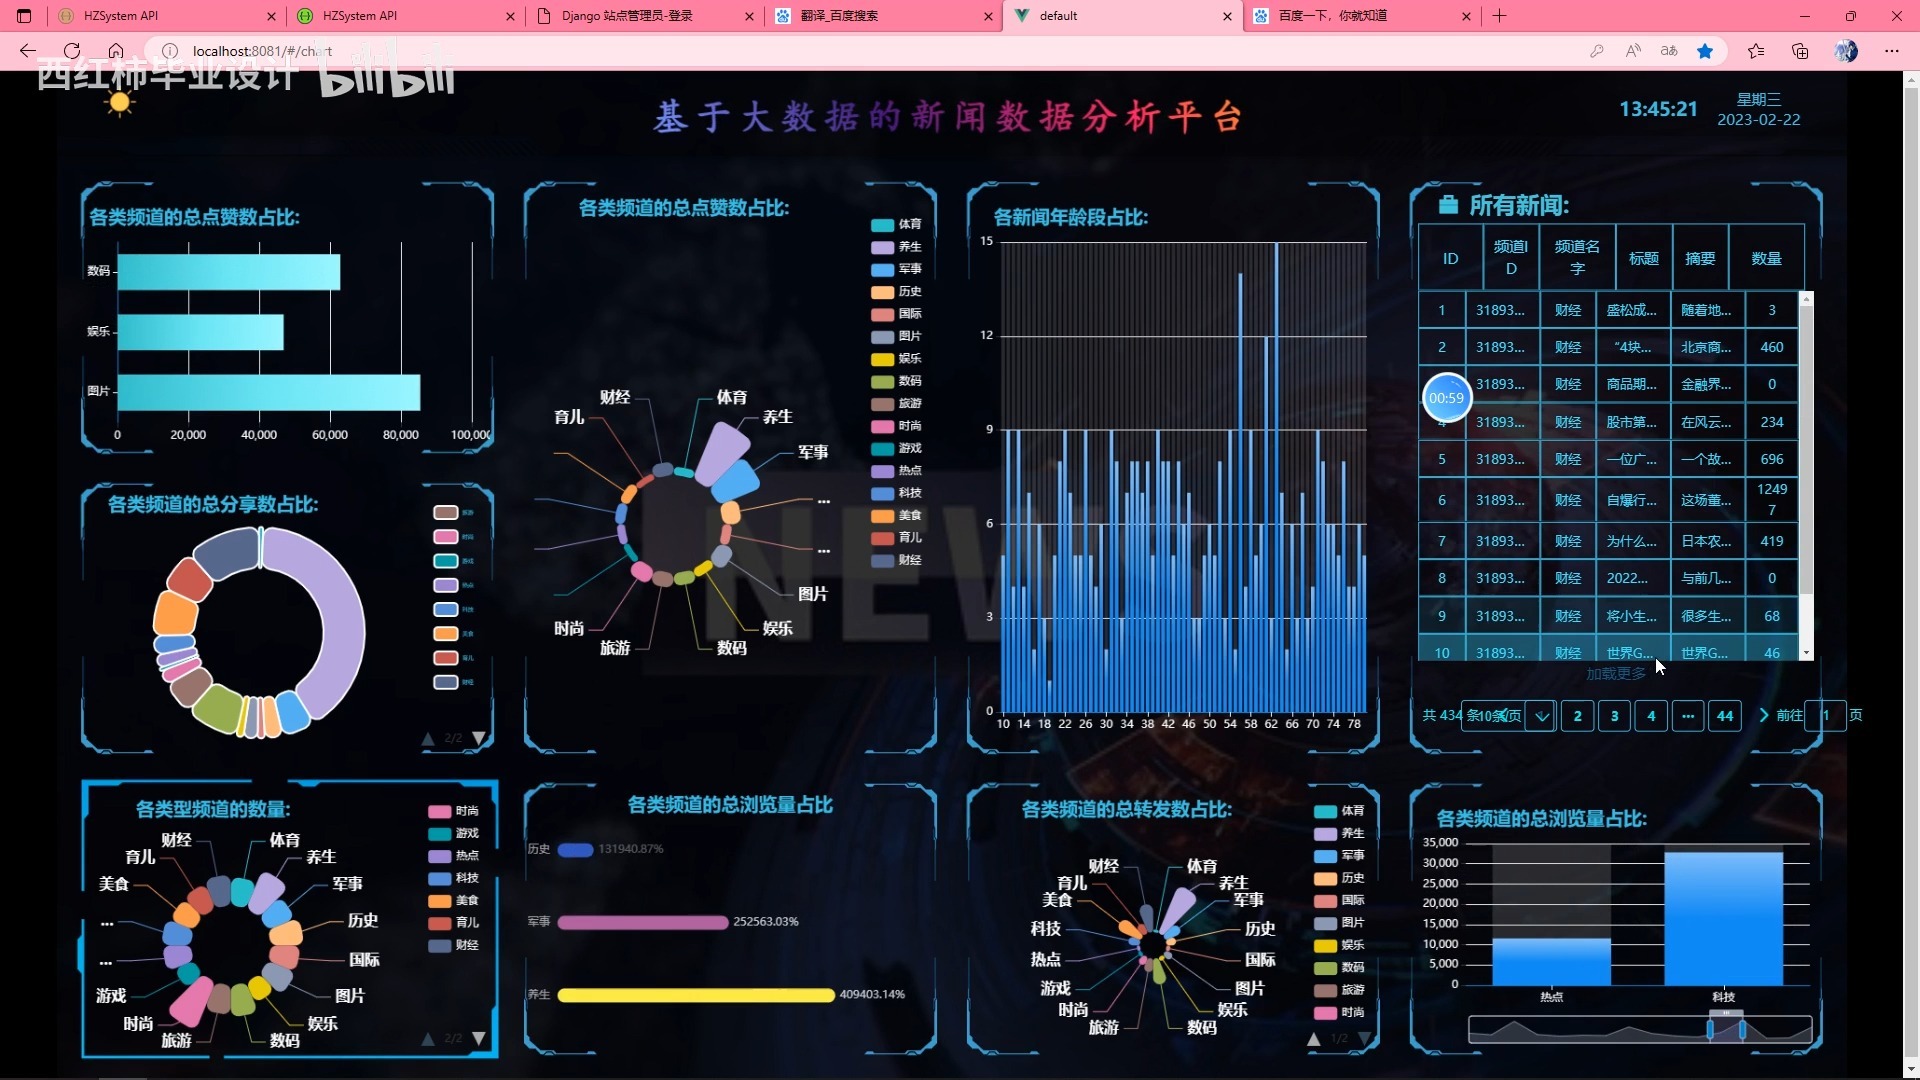
- 數據可視化:將分析結果導出至MySQL或Elasticsearch,通過ECharts或Web頁面展示。
3. 關鍵技術介紹
3.1 爬蟲技術
采用Scrapy框架,結合BeautifulSoup和XPath解析網頁,實現新聞數據的定時抓取。通過設置User-Agent、代理IP和請求延遲應對反爬蟲機制。抓取的數據以JSON格式暫存,隨后上傳至HDFS。
3.2 Hadoop
Hadoop提供分布式存儲(HDFS)和分布式計算(MapReduce)能力。本系統使用HDFS存儲原始新聞數據和中間結果,保證數據的可靠性和高吞吐量。
3.3 Hive
Hive是基于Hadoop的數據倉庫工具,提供SQL-like查詢語言HiveQL。本系統利用Hive建立外部表,對HDFS上的數據進行結構化映射,方便使用SQL進行數據清洗和初步統計。
3.4 Spark
Spark是基于內存的分布式計算框架,比MapReduce更快。本系統使用Spark SQL和Spark MLlib進行復雜的數據分析,如分詞、TF-IDF、情感分析等。Spark的DataFrame API簡化了數據處理流程。
4. 系統實現
4.1 數據采集
編寫Scrapy爬蟲,針對新浪新聞、騰訊新聞等站點進行抓取。定義Item Pipeline將數據保存為JSON文件,并通過Shell腳本定時上傳至HDFS。
4.2 數據預處理
在Hive中創建外部表,關聯HDFS上的原始數據。使用HiveQL進行數據清洗,去除重復、空值,并提取日期、來源等字段。清洗后的數據存入Hive分區表。
4.3 數據分析
使用Spark讀取Hive表,進行以下分析:
- 詞頻統計:使用中文分詞工具HanLP對新聞內容分詞,統計高頻詞。
- 熱點話題:基于TF-IDF提取關鍵詞,結合時間窗口分析熱點演變。
- 情感分析:使用預訓練模型或樸素貝葉斯分類器判斷新聞情感傾向。
- 來源分析:統計不同新聞來源的發布量和熱點分布。
4.4 數據可視化
將Spark分析結果寫入MySQL,前端采用ECharts繪制柱狀圖、詞云和趨勢圖。用戶可通過Web界面交互查看分析結果。
5. 實驗與結果
在3臺虛擬機上搭建Hadoop+Spark集群,爬取約10萬條新聞數據。實驗結果表明,系統能夠高效完成數據采集、存儲和分析任務。詞頻統計顯示“疫情”“經濟”“科技”為近期高頻詞;情感分析準確率達到85%以上。系統具有良好的擴展性,可通過增加節點提升性能。
6. 與展望
本文設計并實現了基于爬蟲+Hadoop+Spark+Hive的新聞數據分析系統。該系統整合了大數據生態圈的多種技術,實現了從數據采集到可視化的全流程。未來工作包括:引入實時流處理(Spark Streaming)實現實時新聞分析;優化情感分析模型;增加多語言支持等。
參考文獻
[1] 李明. 基于Hadoop的海量新聞數據處理與分析[D]. 北京郵電大學, 2021.
[2] 張華, 王強. Spark大數據分析實戰[M]. 電子工業出版社, 2020.
[3] 陳思. 基于Scrapy的新聞爬蟲設計與實現[J]. 計算機應用, 2019, 39(12): 45-49.